A · 2 HOURS
课程快速介绍
第一次接触推理系统,或用于单次专题讲座。中文 60 页,英文 124 页。
Choose a route
三套课件共享同一术语、算例和研究边界,但服务不同教学节奏。
A · 2 HOURS
第一次接触推理系统,或用于单次专题讲座。中文 60 页,英文 124 页。
B · 8 LECTURES
2027 年默认授课节奏。每讲 48 页、2 小时,共 16 小时,适合完整开课。
C · 14 TOPICS
保留 LaTeX Beamer 源码和 PDF,适合按周次拆分、研讨与代码导读。
One request, end to end
课程不把推理缩成一次前向计算,而是追踪请求、状态、控制点和指标的完整闭环。
Visual walkthrough
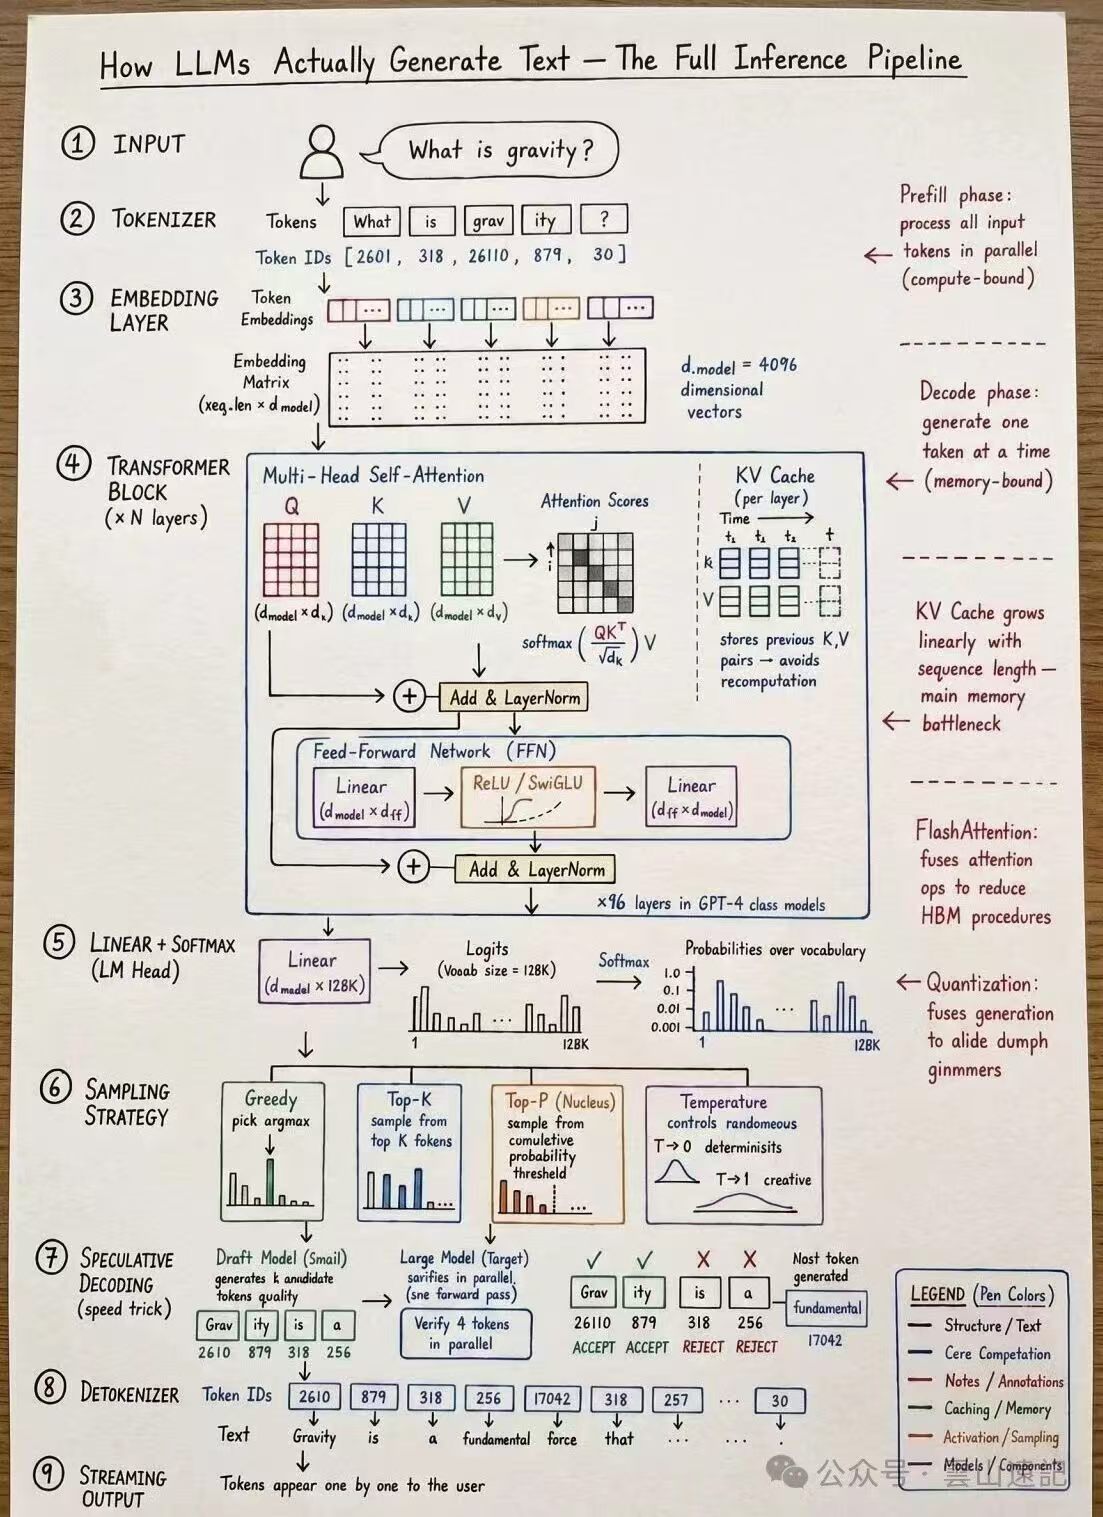
这张图从文本输入一直画到流式输出。阅读时要同时沿着两条线走:模型内部怎样算出下一个 Token,以及服务系统怎样组织许多请求反复执行这个过程。
01 · 两个计算阶段
Prefill 一次处理提示词中的多个位置,为每一层建立 KV Cache。长提示词会显著影响首 Token 延迟,但究竟更偏计算还是访存瓶颈,还取决于序列长度、批大小、算子与硬件。
Decode 每轮为每条序列生成一个新 Token,再把新的 K/V 追加到缓存。单条序列存在严格的前后依赖;系统通常把多条序列连续批处理,以提高设备利用率。
02 · 图外的系统循环
真实服务还要经过聊天模板、准入队列、调度、批次构造、模型执行、采样、流式返回与资源释放。每个调度步都会重新决定哪些请求运行,以及给它们分配多少 Token 预算和 KV 页面。
选请求→读权重与 KV→前向计算→采样→更新状态→流式返回
03 · 最重要的运行时状态
KV Cache 保存每层历史 Token 的 Key 和 Value,避免 Decode 时重复计算全部历史。它通常随上下文长度增长,也是并发容量的重要约束。分页分配可减少碎片,前缀缓存可复用重复上下文;GQA、MQA、量化精度也会改变单 Token 的缓存占用。
Nine stages
前六步回答“下一个 Token 怎样产生”,后三步回答“怎样更快并正确地交付给用户”。
系统消息、角色和用户文本先序列化为模型约定的提示格式,同时确定最大长度、停止条件和采样配置。
文本被编码为 Token ID。Token 不等同于单词,空格、标点、中文字符和字节回退都会影响切分。
词表查找把 ID 变成向量;RoPE 等位置机制让注意力区分顺序。输出形状通常是序列长度乘隐藏维度。
每层依次组合归一化、因果自注意力、残差连接和 MLP。注意力读取历史状态,MLP 对每个位置变换特征。
最后一层隐藏状态映射到词表大小的分数。Decode 通常只需要最后位置的 Logits,而不是重新输出所有位置。
温度、Top-k、Top-p 和重复惩罚共同改变候选分布;贪心解码直接选择最高分 Token,是其中一个特例。
小模型或其他草稿机制先提出多个候选,目标模型一次验证一段,从而减少目标模型串行执行的轮数。
新 ID 被增量还原为文本。实现要处理 UTF-8 字节边界、特殊 Token,以及不能立即显示的不完整字符。
服务端发送可显示片段,并记录 TTFT、TPOT/ITL 与端到端延迟;遇到 EOS、长度上限、停止串或取消后释放资源。
沿着图继续读论文这些工作分别展开注意力访存、KV 管理、推测解码和 Prefill/Decode 资源隔离。
16-hour core course
从系统边界进入,经过机制、架构与优化,最后落到论文验证和开源项目。
Read · Run · Verify
沿着请求入口、调度器、KV 管理和模型执行路径阅读一套最小可运行实现。
进入私有代码仓库(需权限)↗从环境检查、最小复现到可审计实验记录,把系统主张落实为证据。
下载实验 PDF ↓结合 vLLM、SGLang、DistServe、Mooncake、FlashInfer 等工作理解机制边界。
下载 Tutorial PDF ↓Single source of truth
私有仓库保存 PPTX、PDF、源码和版本历史;课程主页同步发布正式 PPTX/PDF,任何人都可直接下载。